 Igor Nascimento
O benchmark que mente depois de vinte minutos
Você monta um servidor com duas ou mais GPUs para atender a equipe, liga, roda o primeiro benchmark e tudo entrega números espetaculares. Vinte minutos depois, com vários usuários conectados, a taxa de tokens por segundo cai quase pela metade. E o pior: sem você ter alterado uma única vírgula de configuração. O culpado não é o software. É a termodinâmica.
O fantasma do thermal throttling
GPUs modernas operam em frequências agressivas, mas ajustam o clock dinamicamente, a cada milissegundo, em função de três limites: temperatura, potência e tensão. Quando o chip atinge o limite térmico, em geral entre 80 e 85 °C para o núcleo, ou quando os módulos de memória GDDR superaquecem (e eles têm limite próprio, frequentemente mais apertado e menos monitorado), a controladora reduz tensão e frequência para proteger o silício. Essa queda derruba a banda efetiva de memória e o throughput de geração despenca junto, porque, como discuti em outros textos, o decode é limitado por banda.
O detalhe cruel é que isso acontece sem erro, sem log, sem alerta. O servidor continua "funcionando". Só funciona mais devagar, e a pessoa que percebe é o usuário, não o operador.
Coolers axiais contra blowers em gabinetes fechados
Placas de vídeo de desktop usam ventiladores axiais, que puxam ar pela frente e expelem o ar quente para dentro do gabinete, pelas laterais e pelas costas da placa. Num computador com uma placa, isso funciona, porque o fluxo do gabinete leva o calor embora. Num servidor com duas ou mais GPUs coladas lado a lado, a placa de cima puxa o ar fervendo que a placa de baixo acabou de expelir. Em poucos minutos de uso contínuo, o conjunto vira uma estufa.
Placas com cooler do tipo blower, uma turbina que empurra o ar por dentro da carcaça e o expulsa pela traseira do chassi, resolvem isso: o calor de cada placa sai do gabinete sem passar pela vizinha. São mais barulhentas e menos comuns em placas de consumo, e é por isso que placas de datacenter têm esse formato ou nem têm ventoinha, contando com o fluxo frontal do rack.
O que o nosso painel mostra
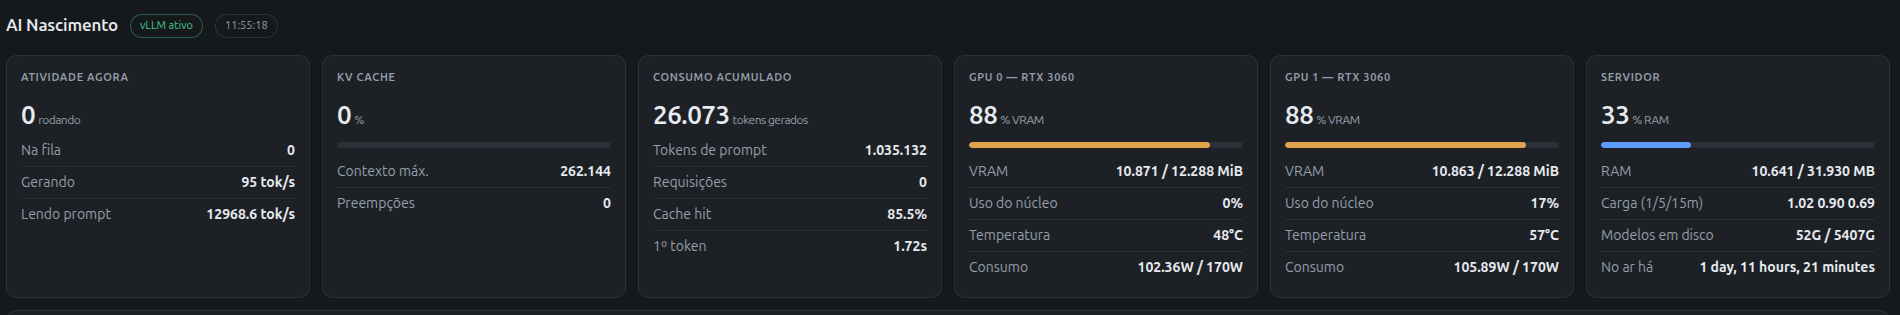
Duas RTX 3060, cada uma com limite de potência de 170 W. Em repouso, com o modelo carregado e nenhuma requisição: 49 °C e 41 °C, consumindo 13 W e 16 W. Sob carga, gerando 95 tokens por segundo e lendo prompt a quase 13 mil: 48 °C e 57 °C, a 102 W e 106 W. Duas coisas me chamam a atenção nesses números.
A primeira é que as temperaturas sob carga estão muito longe do limite de throttling, e isso não foi sorte: foi espaçamento entre as placas e curva de ventoinha ajustada antes de o servidor entrar em uso. A segunda é que a placa mais quente é a que mostra 17% de uso de núcleo, e a outra, 0%, no instante da captura. É o decode sendo limitado por memória: os núcleos quase ociosos, a memória trabalhando, e ainda assim 100 W de consumo. A energia está indo para a GDDR6 e para o movimento de dados, não para cálculo.
O ajuste contraintuitivo: limitar potência
Aqui está o ponto que quase ninguém faz porque parece errado. Em decode, a GPU é limitada por banda de memória. Os núcleos não estão no limite. Isso significa que baixar o limite de potência da placa custa muito pouco em tokens por segundo, porque o clock do núcleo não era o gargalo, e corta calor e consumo de forma desproporcional, porque potência cresce mais que linearmente com tensão e frequência.
Numa RTX 3060, levar o limite de 170 W para algo como 120 ou 130 W tipicamente custa poucos por cento de throughput em decode e reduz bastante a temperatura em regime contínuo. Em prefill pesado, que é limitado por computação, o custo é maior, e é por isso que o ajuste precisa ser medido no seu padrão de uso, não copiado. Mas para um servidor de conversa, é a alavanca de maior retorno por esforço: um comando, zero hardware novo, e o throttling deixa de ser uma ameaça porque a placa nunca chega perto do limite térmico.
Limitar potência troca pico por consistência. Você abre mão de alguns por cento no melhor caso para garantir que o pior caso, depois de vinte minutos de carga, seja igual ao primeiro minuto. Para um benchmark de cinco minutos, é uma perda. Para um servidor que atende gente o dia inteiro, o número que importa é o sustentado, não o de pico, e o sustentado melhora.
O que exige cuidado estrutural
Garantir que um servidor de LLM opere 24 horas por dia sem degradação exige decisões que se tomam na montagem, não depois:
- Espaçamento real entre slots. Pelo menos um slot livre entre as placas, para que a de cima tenha de onde puxar ar fresco. Isso restringe a escolha de placa-mãe e de gabinete, e vale a restrição.
- Curvas de ventoinha customizadas. O perfil padrão de uma placa de desktop é feito para ser silencioso em jogos, com a ventoinha subindo tarde. Para inferência contínua, a ventilação precisa atuar antes de o chip esquentar, não depois. Barulho é um custo aceitável num servidor; throttling, não.
- Fluxo do gabinete com direção definida. Entrada na frente, saída atrás e em cima, com pressão levemente positiva para não acumular poeira. Ventoinhas apontando umas contra as outras cancelam o fluxo.
- Monitoramento de potência e temperatura, com histórico. Acompanhar se a placa está no limite de potência ou sendo estrangulada por calor. Não basta olhar o número agora; é preciso ver a curva ao longo de uma hora de carga, porque é nela que o throttling aparece. O painel que uso registra temperatura e consumo justamente por isso.
- Fonte com margem. GPUs têm picos transitórios de consumo bem acima do limite nominal. Duas placas de 170 W numa fonte de 500 W funcionam até o dia em que as duas picam juntas. Margem de fonte é seguro barato.
Fazer inteligência artificial funcionar com consistência é metade arquitetura de software e metade engenharia térmica e elétrica. A primeira metade está na documentação do vLLM. A segunda está no gabinete, e ninguém escreve post sobre ela.
Resumo da conversa
- O throughput cai depois de minutos porque a GPU reduz clock ao atingir limite térmico, de núcleo ou de memória. Sem erro, sem log.
- Coolers axiais jogam ar quente no gabinete; em multi-GPU, a placa de cima respira o calor da de baixo. Blowers ou espaçamento resolvem.
- No nosso painel: 48 e 57 °C sob carga, a cerca de 100 W de 170 W, com os núcleos quase ociosos. Decode é memória, não cálculo.
- Limitar potência custa pouco em decode e elimina o throttling. Troca pico por consistência, que é o que um servidor precisa.
- Espaçamento, curva de ventoinha, fluxo com direção, monitoramento com histórico e fonte com margem se decidem na montagem.